С чего началась работа
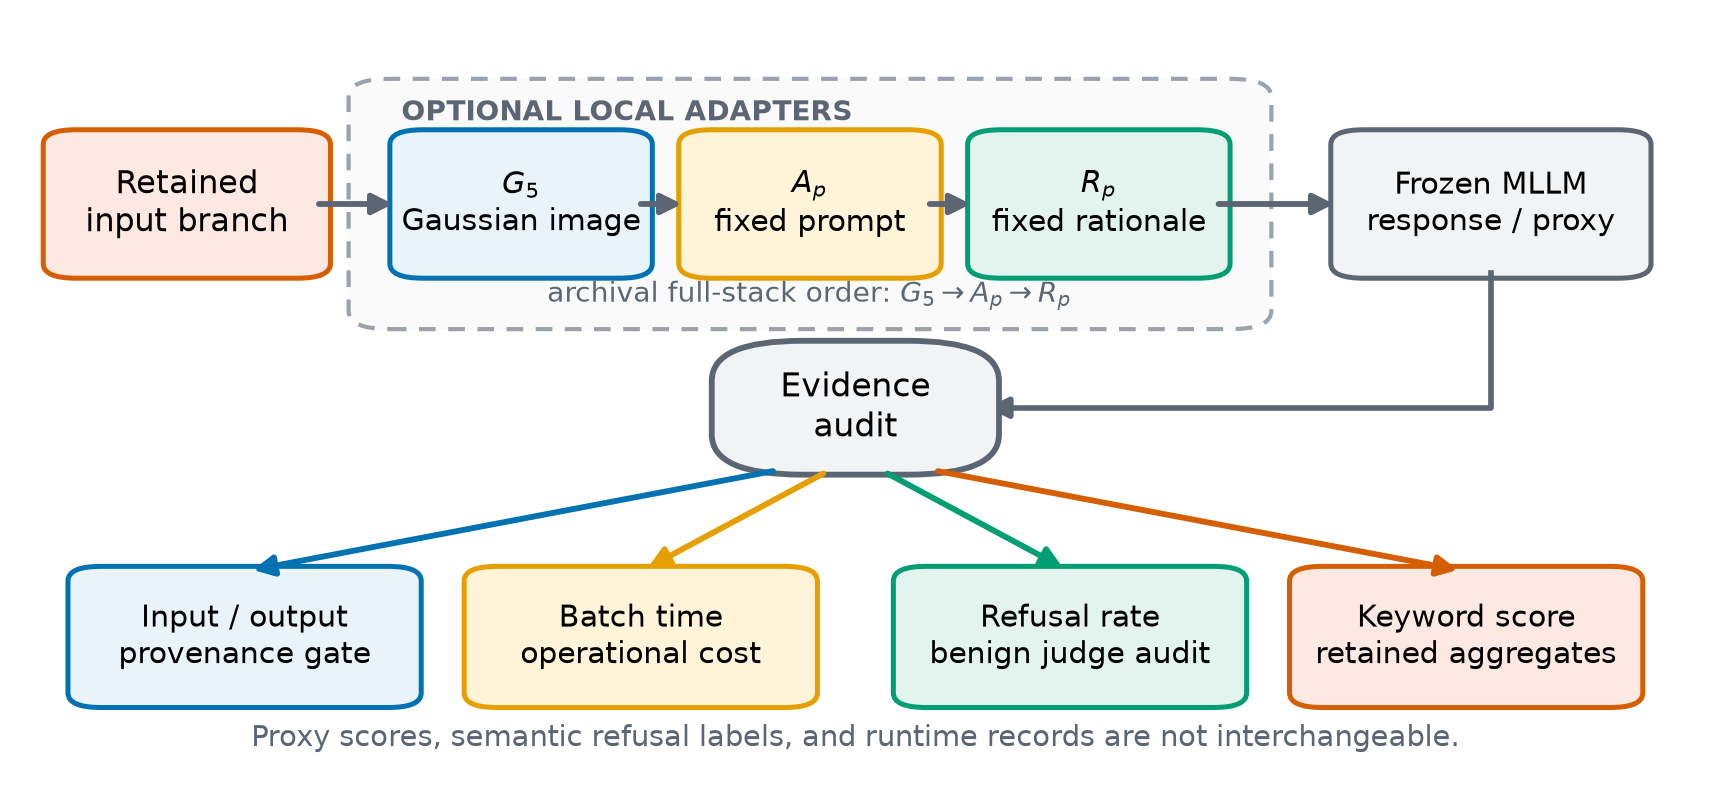
Мы сравнивали три простые защиты, которые включаются во время работы модели: обычный защитный промпт, промпт с коротким рассуждением о безопасности и обработку изображения гауссовским шумом с голосованием по пяти запускам. Это локальные варианты, вдохновлённые AdaShield, RapGuard и SmoothVLM, а не точные реализации этих методов.
Сначала вопрос звучал привычно: какая защита лучше? Но при проверке экспериментального архива выяснилось, что отвечать на него рано. Нужно было сначала понять, получала ли модель правильные данные, сохранился ли её настоящий ответ и измеряет ли оценщик именно безопасность, а не случайные слова в тексте.
Можно ли вообще верить исходным данным
Для каждого результата мы задавали три простых вопроса:
- Модель точно получила нужный текст и нужное изображение?
- Сохранился именно тот ответ, который увидел бы пользователь?
- Проверяющий метод действительно распознаёт вредный ответ или отказ, а не просто ищет знакомые слова?
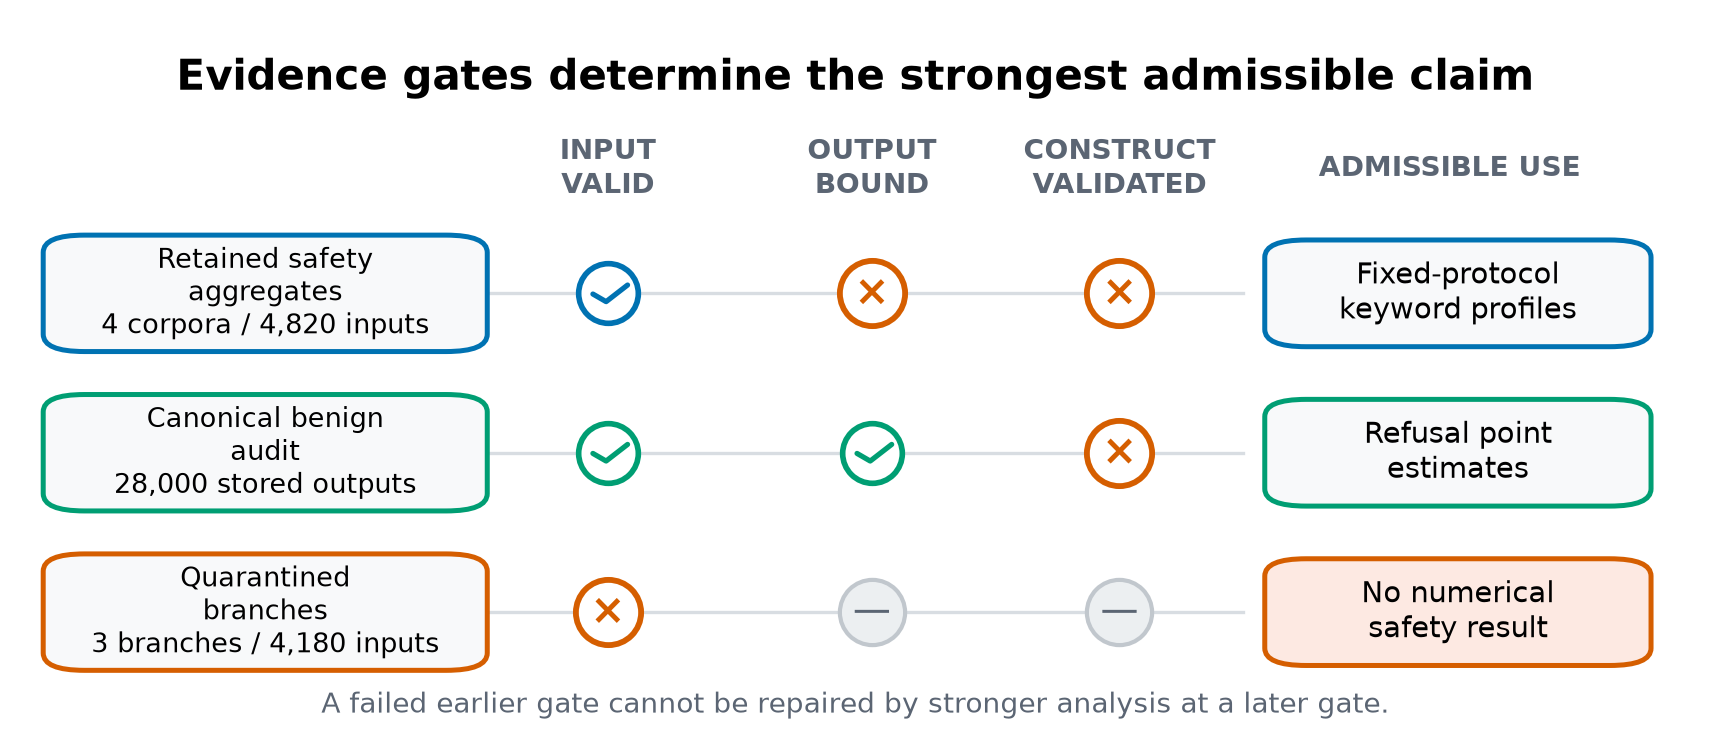
В плане было 9000 входов. После проверки мы оставили четыре набора данных — FigStep, текстовую часть JailBreakV, SALAD-Bench и HarmBench-Simple. Вместе это 4820 входов на каждую основную конфигурацию. Ещё 4180 входов пришлось исключить из численных выводов.
Причины были вполне конкретными. Для MM-SafetyBench бралось не то поле с данными. В мультимодальной части JailBreakV отсутствующее изображение могло незаметно превратить запрос в текстовый. А ветка с adversarial patch рисовала текст и случайный прямоугольник вместо заявленной оптимизированной атаки.
Это нельзя исправить повторной проверкой готовых ответов: если изображение не дошло до модели, его уже не восстановить. Для четырёх оставшихся наборов сохранились итоговые таблицы, но не все ответы по отдельным примерам. Поэтому по ним можно изучать поведение старого оценщика, но нельзя строить надёжный рейтинг безопасности.
Как защита обманула оценщик
Старый скрипт искал в ответах заранее заданные слова. Среди признаков отказа были harmful, unsafe и unethical. Но те же слова использовал защитный промпт: он просил модель сначала сказать, не является ли запрос вредным или незаконным.
Получалась странная ситуация. Модель могла начать с фразы о безопасности, а затем всё-таки дать содержательный ответ. Скрипт видел знакомое слово и считал, что модель отказалась. В таблицах безопасности такая же лексика могла сделать ответ «безопасным», даже если после вступления шла вредная инструкция. Пустой ответ тоже считался безопасным, потому что в нём не находилось ни одного запрещённого слова.
На специально отобранных 246 ответах старый скрипт назвал вредными 72 ответа, но независимая модель-проверяющий согласилась только с 30 из них. При этом она нашла ещё 13 вредных ответов, которые скрипт пропустил. Эта выборка не показывает общую частоту ошибок, но ясно показывает, что простому поиску слов доверять нельзя.
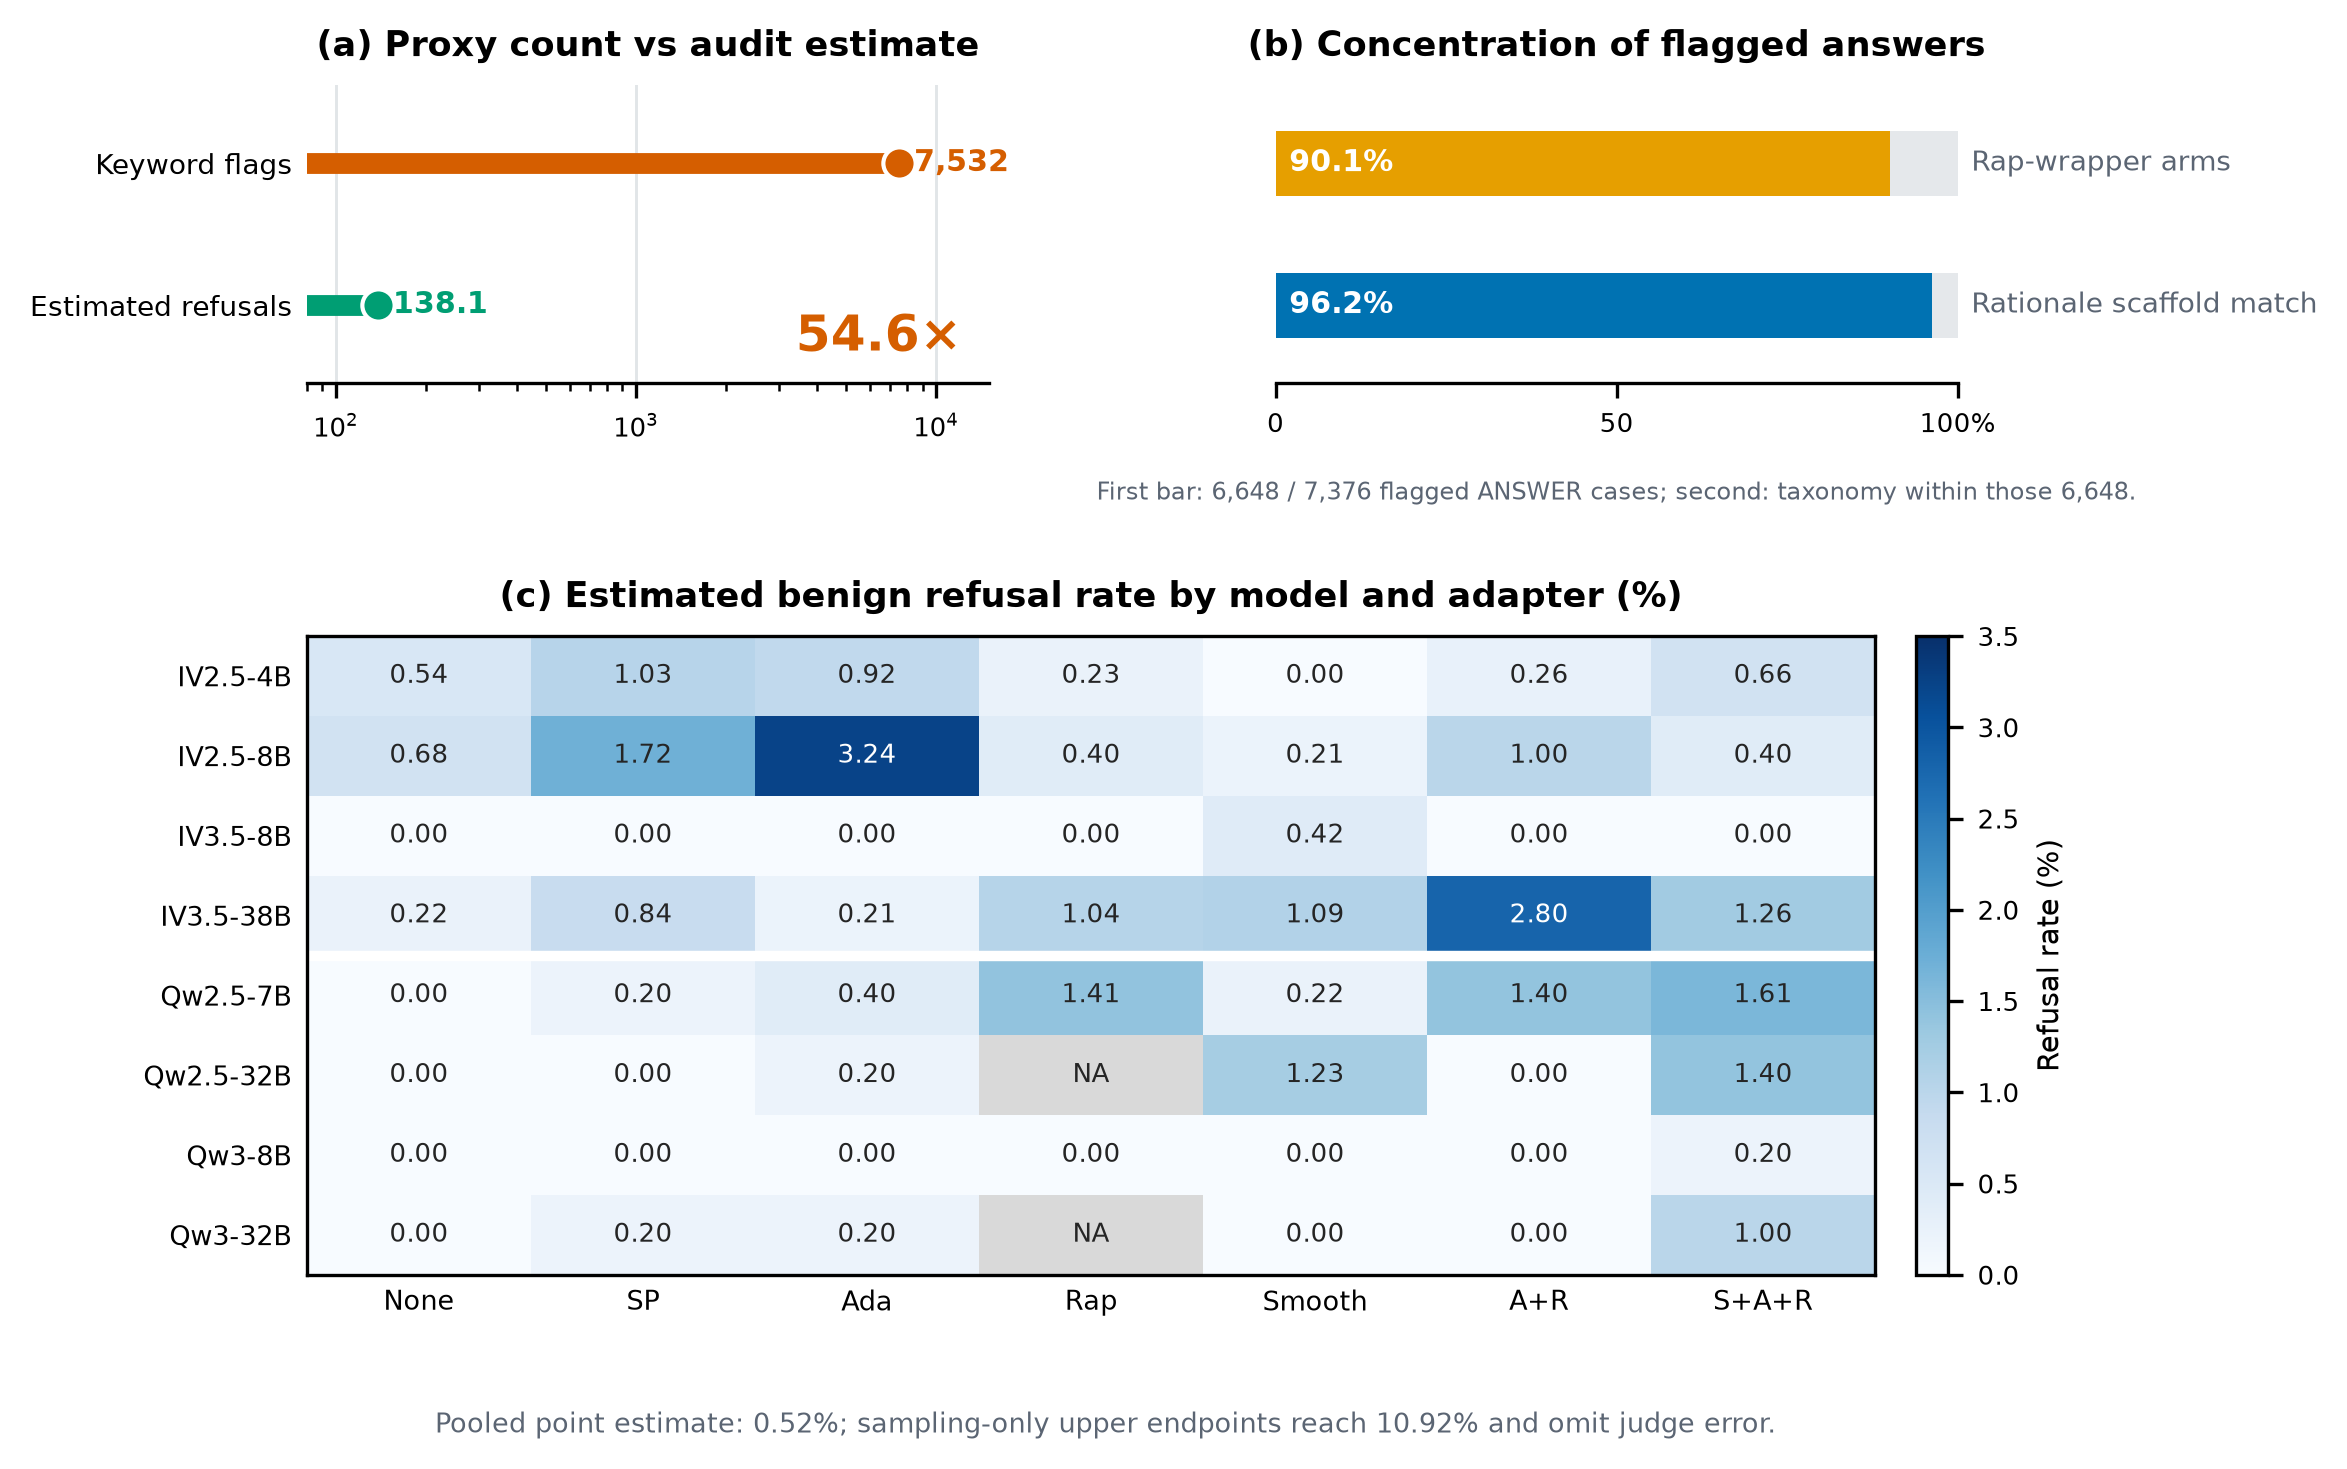
Самый наглядный результат получился на 28 000 обычных, безопасных запросов:
- скрипт поставил 7532 отметки об отказе;
- отдельная проверка оценила реальное число отказов примерно в 138;
- разница составила 54,6 раза;
- почти все лишние отметки были связаны с промптом, который просил модель рассуждать о безопасности.
Это не небольшая погрешность, одинаковая для всех вариантов. Ошибка особенно сильно проявляется именно там, где включён защитный промпт. Поэтому сравнение смешивает две вещи: как защита меняет поведение модели и как она меняет реакцию оценщика.
Что осталось после проверки
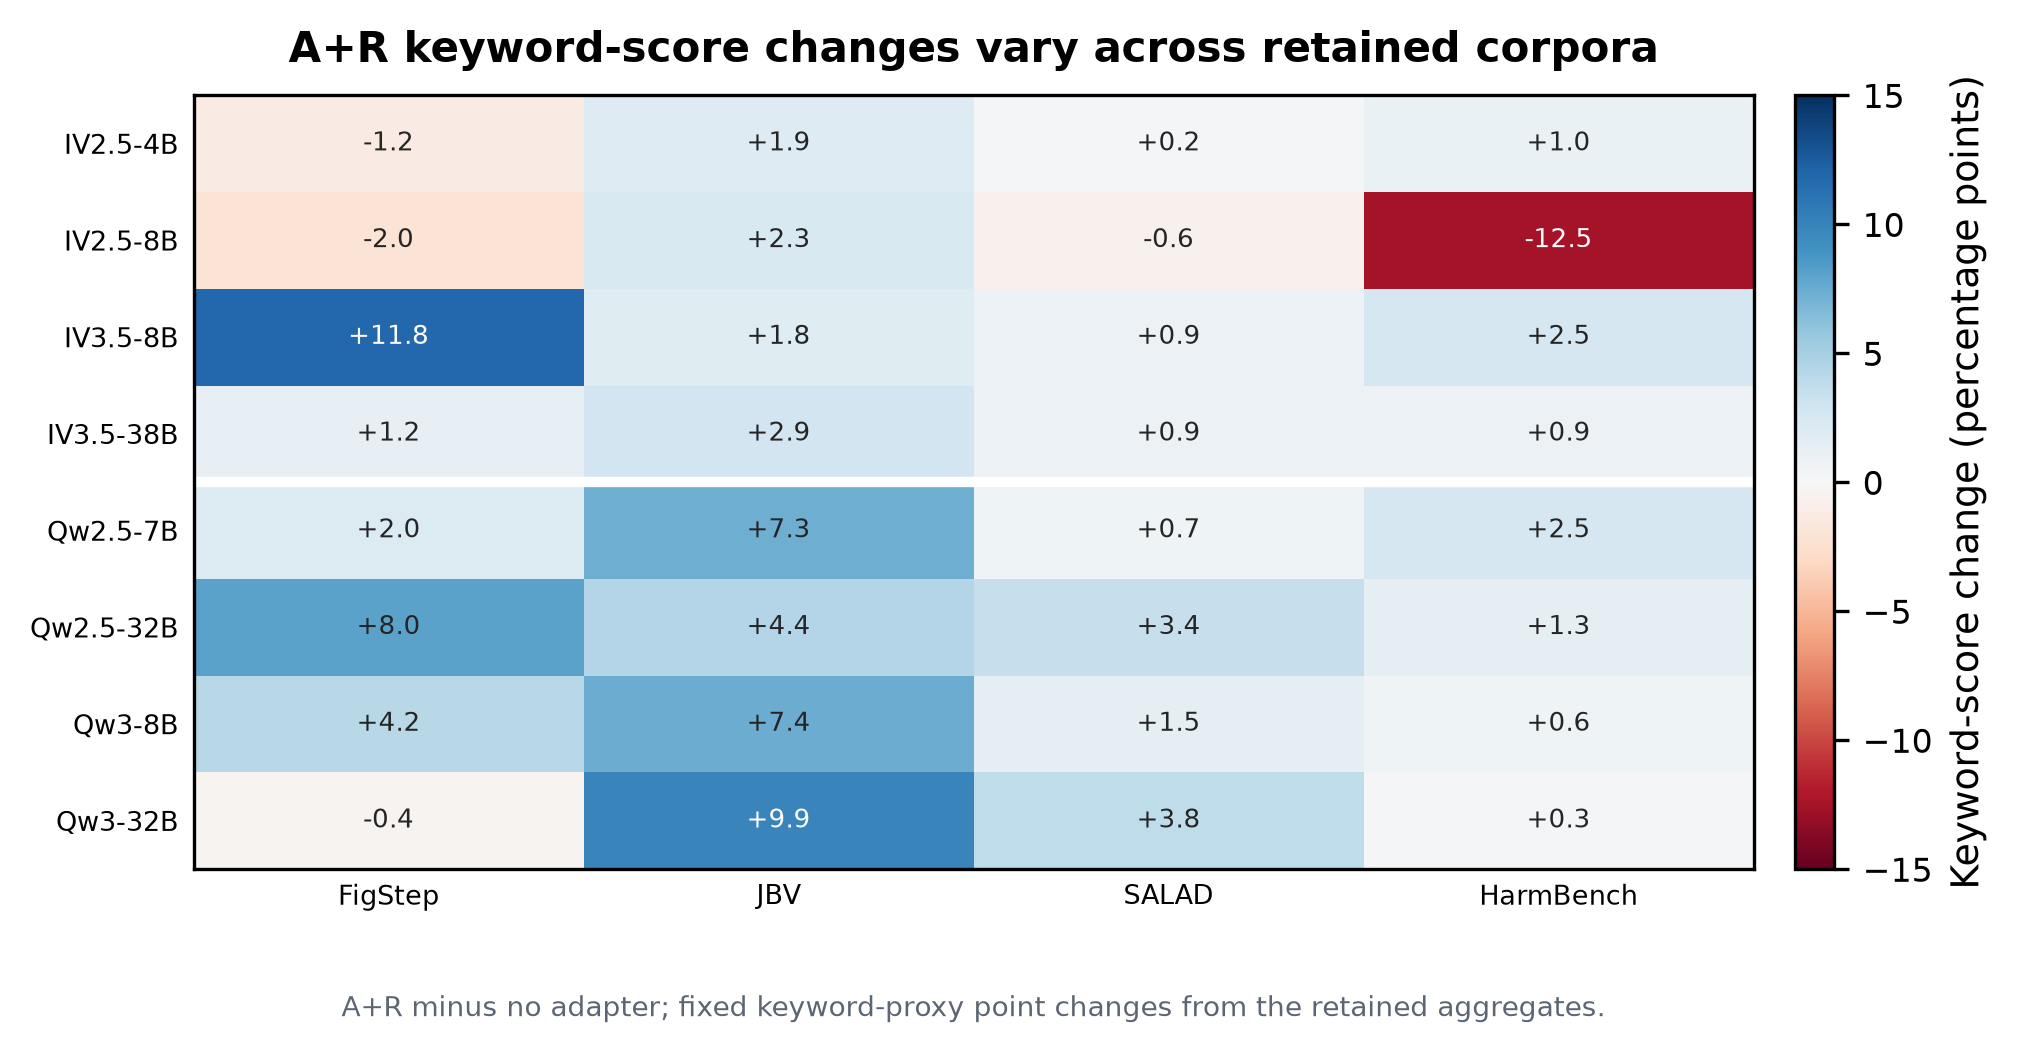
На четырёх наборах данных результаты всё равно заметно различаются между моделями. В 27 из 32 пар «модель — набор данных» сочетание двух защитных промптов повышало оценку старого скрипта. Но это как раз тот случай, где улучшение может объясняться повторением слов из защитного промпта, а не реальной безопасностью.
Самые крупные изменения — +11,8 процентного пункта для InternVL3.5-8B на FigStep и −12,5 для InternVL2.5-8B-MPO на HarmBench. Эти случаи стоит проверить заново на сохранённых ответах и с независимой смысловой оценкой. Сами по себе цифры не доказывают, что защита помогла или навредила.
На обычных запросах средняя оценка доли отказов составила 0,52%, а максимум среди ячеек, которые удалось оценить, — 3,24%. Это не похоже на массовые отказы, но и сравнивать небольшие различия между защитами пока нельзя: отказов мало, а проверяющая модель не всегда одинаково размечала редкие спорные случаи.
Мы также измерили вычислительные затраты. Обработка изображения с пятью запусками занимала в 5,45–12,76 раза больше пакетного времени, а полный набор защит — в 4,36–16,59 раза больше варианта без защиты. Это время обработки серии запросов, а не задержка одного запроса, и оно ничего не говорит об эффективности защиты. Точность на обычных заданиях мы не приводим: в сохранённых промптах не было вариантов ответа A–D, поэтому старую оценку корректно пересчитать невозможно.
Главный вывод
Если защитный промпт использует те же слова, которые ищет оценщик, итоговая цифра говорит не только о безопасности модели. Она ещё и показывает, насколько легко защита повлияла на сам способ измерения.
Для честного сравнения нужно сохранять всю цепочку: точный вход и изображение, версию модели, защитный промпт, ответ, который увидел пользователь, ошибки и запасные сценарии, а также версию оценщика. После этого ответы нужно проверять по смыслу, а не только по словам. Без такой цепочки аккуратная таблица процентов остаётся отчётом о работе экспериментального конвейера, а не доказательством безопасности.